 Status





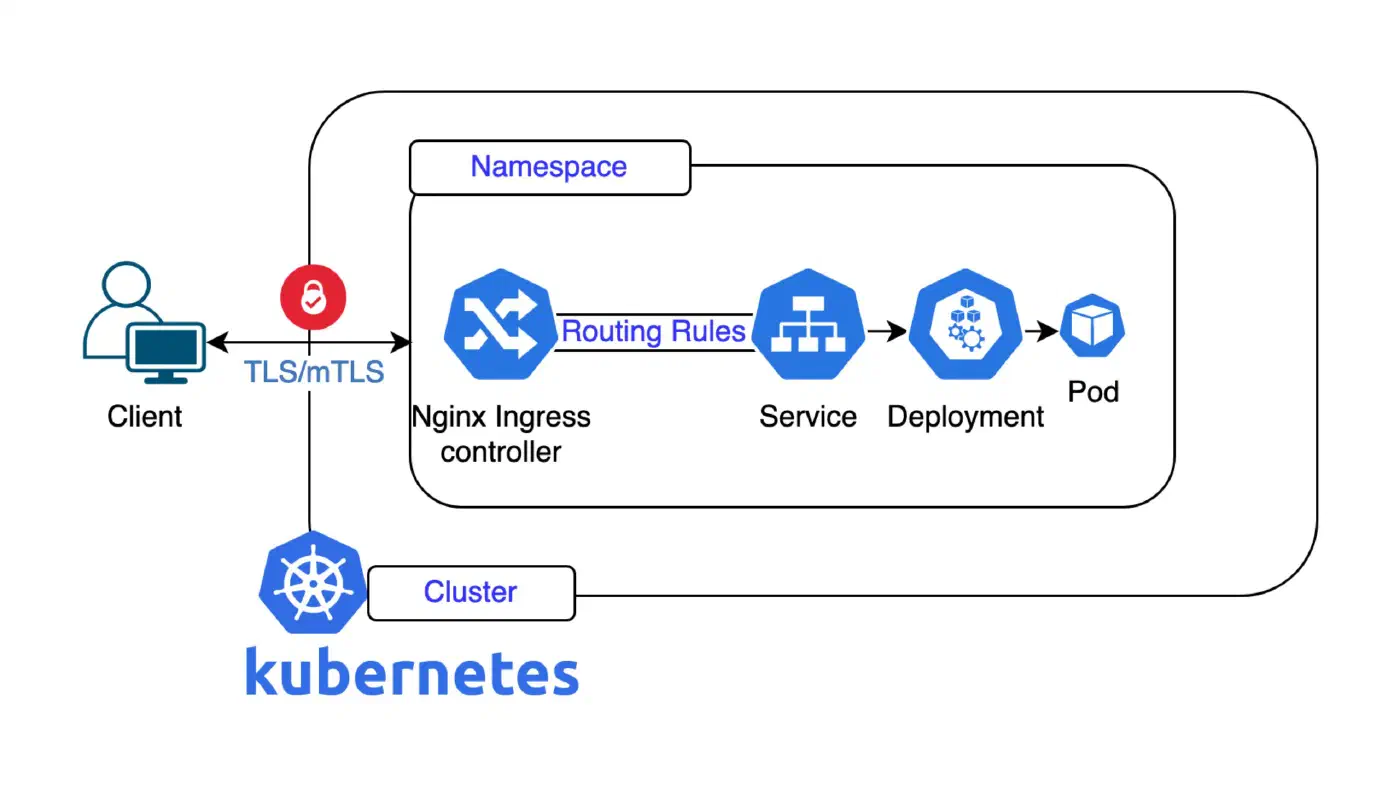





In den letzten Wochen haben wir die Managed Services auf den Service-Clustern von NKE und Deploio von ingress-nginx auf HAProxy umgezogen, also alles, was Kundinnen und Kunden direkt nutzen: Grafana, Loki, ArgoCD, die Container Registry, Alertmanager, Tempo, OpenSearch, die Object-Storage-Endpunkte und sämtliche Deploio-Applikationen. Auf einzelnen Clustern lagen allein über 200 Ingresses.
Warum wir diesen Schritt gemacht haben, haben wir schon zweimal beschrieben. Im Dezember ging es darum, was das Ende von ingress-nginx bedeutet und welche Wege für eine Migration offenstehen. Im Rückblick auf TechTalk #29 ging es um unseren Vergleich von Traefik, Gateway API und HAProxy, und darum, weshalb HAProxy auf NKE unser Standard für klassische Ingresses wurde.
In diesem Beitrag geht es um die Zeit danach.
Mit der Annotation-Tabelle in unserer Dokumentation hast du einen funktionierenden Ingress auf HAProxy in wenigen Minuten. Was die Tabelle nicht zeigt: wie sich darunter die Defaults verschieben. Zwei Ingress Controller können dieselbe Ingress-Ressource lesen und sich trotzdem darin unterscheiden, wie sie mit deinen Backends reden, welche Statuscodes sie zurückgeben, wie lange sie warten und wie viele Verbindungen sie annehmen, bevor sie neue ablehnen.
Die meisten dieser Unterschiede haben wir erst im Betrieb nach der Umstellung bemerkt. Einer davon hat bei einem Kunden die Auslieferung der Website-Assets lahmgelegt. Wir teilen sie hier, damit du dein eigenes Setup vor der Migration prüfen kannst.
Weiterleitung von HTTP auf HTTPS
Beim Vergleich der Antworten beider Controller fiel uns auf, dass HAProxy unverschlüsselte HTTP-Anfragen mit 302 Found weiterleitete. nginx hatte dafür 308 Permanent Redirect verwendet.
ingress-nginx setzt http-redirect-code standardmässig auf 308. Das Gegenstück bei haproxy-ingress heisst ssl-redirect-code und steht auf einem temporären 302. Browser folgen beiden, API-Clients, Such-Crawler und Caches dazwischen behandeln sie aber unterschiedlich. Bei einem 302 dürfen Clients aus einem POST einen GET machen, ein 308 behält Methode und Body bei.
Ein unbemerkter Wechsel auf temporäre Weiterleitungen kann API-Clients aus dem Tritt bringen. Deshalb setzen wir ssl-redirect-code: "308" global auf unseren Managed Controllern, damit das bisherige Verhalten bleibt.
Verbindungslimits
Bei hohem Traffic wurden Anfragen an Deploio-Applikationen langsamer, und ein Teil der neuen Verbindungen wurde abgelehnt.
Der Grund war das Verbindungslimit. nginx und HAProxy berechnen ihre Obergrenze unterschiedlich:
- nginx multipliziert
worker_processesmitworker_connections. Weilingress-nginxworker_processesauf die Anzahl CPUs des Nodes undworker_connectionsauf16384setzt, schafft schon ein bescheidener Node Zehntausende gleichzeitige Verbindungen. - HAProxy kennt ein einziges globales
maxconn.haproxy-ingressstellt es alsmax-connectionsbereit und setzt es standardmässig auf 2'000 pro Pod.
Ist diese Grenze erreicht, nimmt HAProxy keine neuen Verbindungen mehr an. Sie warten dann im Accept-Backlog des Kernels, daher die Verlangsamung. Ist auch der Backlog voll, werden sie verworfen.
Wir haben max-connections auf allen Managed Controllern auf 20'000 erhöht.
Timeouts
Kurz nach der Migration von Deploio schlugen bei einigen Kundinnen und Kunden Anfragen mit 504 Gateway Timeout fehl.
haproxy-ingress setzt timeout-client und timeout-server standardmässig auf 50 Sekunden, ingress-nginx wartet 60 Sekunden. Für normale Webanfragen spielen die zehn Sekunden keine Rolle. Datenexporte oder Reports, die zuverlässig nach 55 Sekunden fertig waren, brachen aber plötzlich mit einem 504 ab.
Damit Anfragen, die bisher durchliefen, nicht abgeschnitten werden, setzen unsere Managed Controller beide Timeouts auf 60 Sekunden. Pro Ingress kannst du den Wert weiterhin anpassen, mit haproxy-ingress.github.io/timeout-server anstelle von nginx.ingress.kubernetes.io/proxy-read-timeout.
HTTP-Version zum Upstream
Im Juli haben wir einen S3-kompatiblen Endpunkt unseres Object Storage auf HAProxy umgestellt. Ein Kunde lieferte darüber Website-Assets aus, mit einem eigenen nginx als Reverse Proxy davor. Direkt nach der Umstellung schlug jede Anfrage nach einem Asset mit 400 Bad Request fehl.
Die Ursache: proxy_pass in nginx spricht mit Upstreams standardmässig HTTP/1.0. ingress-nginx redete mit Backends immer HTTP/1.1, unabhängig vom Protokoll des Clients, und hob die HTTP/1.0-Anfragen des Kunden damit stillschweigend an. HAProxy leitet die Anfrage in der Version weiter, die der Client geschickt hat. Das Backend des Object Storage lehnte HTTP/1.0 ab, daher die 400er-Fehler.
Gelöst hat es der Kunde mit einer Zeile proxy_http_version 1.1 in der Konfiguration seines Reverse Proxy:
location / {
    proxy_pass http://storage-endpoint;
    proxy_http_version 1.1;
}
Betreibst du selbst einen Reverse Proxy vor einem Ingress auf NKE oder Deploio, prüf, welche HTTP-Version er schickt.
Basic Auth
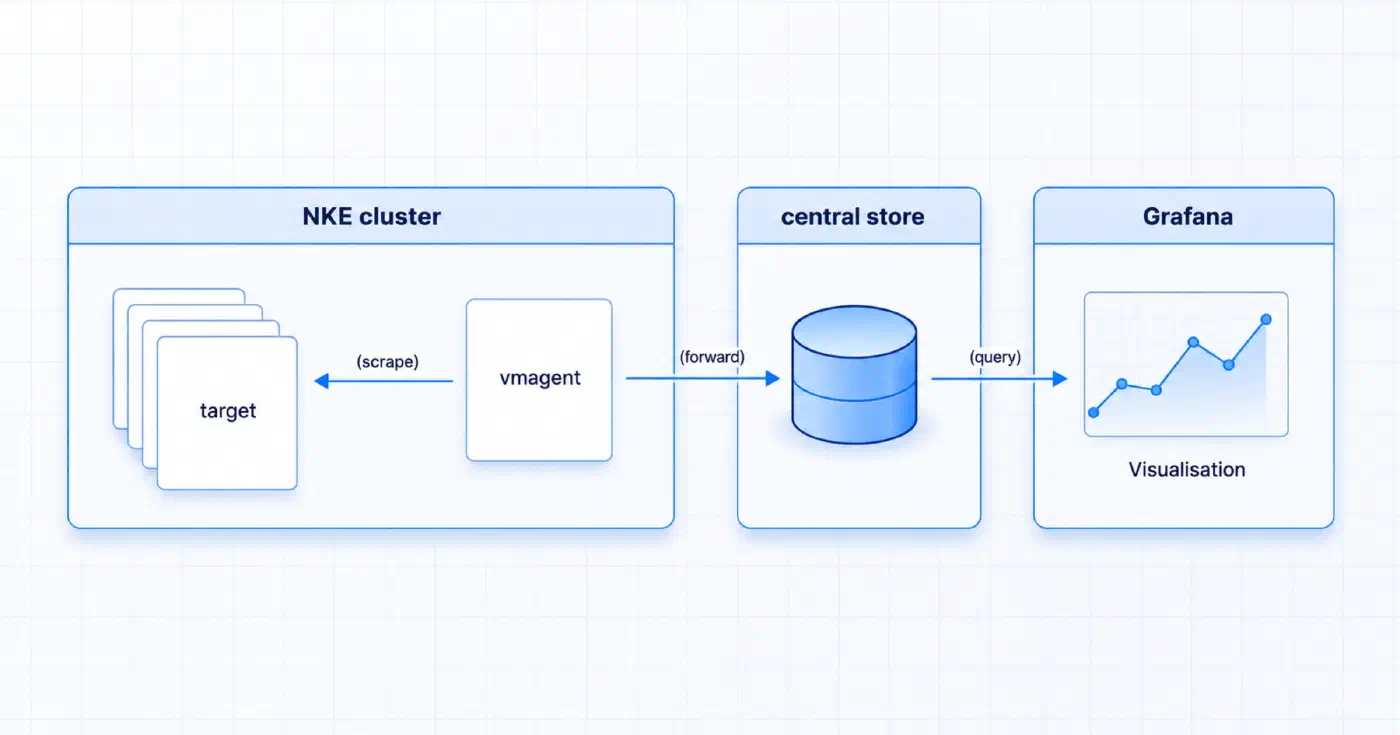
Als die meisten Managed Services umgezogen waren, brauchte einer der Controller plötzlich mehr als zwei volle CPU-Kerne, obwohl er nur 155 gleichzeitige Verbindungen bediente. Fast der ganze Traffic auf diesem Pod ging an zwei Endpunkte mit HTTP Basic Authentication, einer davon unsere Pipeline für die Metrik-Erfassung.
HAProxy prüft Basic Auth bei jeder Anfrage synchron über crypt(3), ohne Cache. Ein bcrypt-Hash mit Cost-Faktor 10, dem Standard der meisten Bibliotheken und der htpasswd-Funktion in Helm, braucht zur Prüfung rund 50 ms CPU-Zeit. Bei 50 ms pro Prüfung reichen zwanzig Anfragen pro Sekunde, um einen ganzen CPU-Kern auszulasten.
Das gilt auch für nginx: Das Modul auth_basic prüft ebenfalls jede Anfrage synchron und cacht ebenso wenig. Jeder nginx-Worker ist eine Event-Loop mit nur einem Thread, eine Prüfung von 50 ms hält also alle Verbindungen dieses Workers an. Die Worker sind aber eigene Prozesse, ein Controller mit acht Workern prüft also acht Passwörter parallel.
HAProxy verwendet das thread-sichere crypt_r(3) nur unter glibc und FreeBSD. Auf allen anderen Plattformen, auch auf dem Alpine-basierten Image von haproxy-ingress, sichert es den einfachen crypt(3)-Aufruf mit einem einzigen Spinlock für den ganzen Prozess. Nur ein Thread kann gleichzeitig ein Passwort prüfen, das begrenzt den ganzen Pod auf etwa zwanzig Prüfungen pro Sekunde, egal wie viele Kerne er hat. Und weil es ein Spinlock ist, schlafen wartende Threads nicht, sie halten ihre Kerne beschäftigt, bis sie dran sind. So kam ein Pod mit 155 Verbindungen auf mehr als zwei Kerne.
Das HAProxy-Handbuch warnt, gehashte Passwörter könnten «quickly become a major factor in HAProxy’s overall CPU consumption», und weist darauf hin, dass die Hash-Implementierungen von musl langsamer sind als die von glibc. Ein Wunsch, erfolgreiche Basic-Auth-Prüfungen zu cachen, ist upstream seit 2019 offen: haproxy/haproxy#370.
Für Zugangsdaten, die wir intern erzeugen, haben wir den bcrypt-Cost auf 4 gesenkt. Die Prüfung dauert damit unter einer Millisekunde. Das ist unbedenklich, weil diese Passwörter lange, maschinell erzeugte Zeichenketten aus 20 zufälligen Zeichen sind. Ein Brute-Force-Angriff ist damit rechnerisch nicht machbar, unabhängig vom Cost-Faktor. Die eingebaute htpasswd-Funktion von Helm hasht immer mit dem bcrypt-Standard von 10 und lässt sich nicht umstellen (Sprig-Quellcode). Zugangsdaten aus Helm Charts müssen deshalb ausserhalb von Helm gehasht werden.
Die Annotation ist bei HAProxy einfacher. haproxy-ingress.github.io/auth-secret allein aktiviert die Authentifizierung, auth-type ist veraltet. Das Format des Secrets bleibt gleich: eine htpasswd-Datei unter dem Schlüssel auth.
X-Forwarded-For
Auf dem Papier sieht das nach einer Verhaltensänderung aus. In der Praxis ist es keine, es kommt aber ein Header dazu.
ingress-nginx ersetzte ein eingehendes X-Forwarded-For durch die IP der Verbindung, ausser die clusterweite Option compute-full-forwarded-for war aktiv. Auf unseren gemeinsam genutzten Controllern war sie das nicht.
option forwardfor von HAProxy verhält sich für sich genommen anders: Es hängt die verbindende IP an. Hat der Client schon ein X-Forwarded-For mitgeschickt, bekommt das Backend beides. Applikationen hinter einem CDN oder Reverse Proxy sähen dann die ganze Proxy-Kette statt des einzelnen Werts, den ingress-nginx geliefert hat.
haproxy-ingress schliesst diese Lücke. Der Schlüssel forwardfor steht standardmässig auf add: Damit wird ein eingehendes X-Forwarded-For gelöscht, bevor HAProxy die verbindende IP einträgt. Deine Applikation sieht also dasselbe wie vorher, eine einzige Adresse, nämlich die, die sich direkt mit dem Ingress verbunden hat, zum Beispiel dein CDN.
Neu ist ein zusätzlicher Header. Brachte die Anfrage schon ein X-Forwarded-For mit, kopiert haproxy-ingress den ursprünglichen Wert nach X-Original-Forwarded-For, bevor es ihn verwirft:
X-Forwarded-For: <cdn-or-proxy-ip>
X-Original-Forwarded-For: <whatever-the-client-sent>
Für sich allein ist X-Original-Forwarded-For nicht vertrauenswürdig. Der Wert wird unverändert von dem übernommen, der sich mit dem Ingress verbindet, und da kann jede und jeder hineinschreiben, was sie oder er will.
Nützlich wird der Header, sobald deine Applikation prüft, wer sich verbunden hat. X-Forwarded-For enthält die Adresse, die die TCP-Verbindung zu HAProxy aufgebaut hat, und die kann der Client nicht fälschen. Gehört sie zu einem CDN, dem du vertraust, zum Beispiel zu einer der veröffentlichten Edge-IPs deines Anbieters, dann ist X-Original-Forwarded-For der Header, den dieses CDN geschickt hat. Der Eintrag ganz rechts ist die Adresse, die sich aus Sicht des CDN mit ihm verbunden hat.
HSTS-Header
haproxy-ingress setzt den Header Strict-Transport-Security standardmässig auf max-age=15768000, also sechs Monate. ingress-nginx schickte max-age=31536000, ein Jahr.
RFC 6797 überlässt die Dauer dem Betreiber, und die beiden Projekte orientieren sich an unterschiedlichen Massstäben. Sechs Monate verlangt Qualys SSL Labs seit Januar 2014 mindestens für ein A+. Die Beispiele in der HAProxy-Dokumentation liegen knapp darüber, bei max-age=16000000, beschrieben als «a bit more than 6 months». Als HAProxy diese Beispiele veröffentlichte, akzeptierte die HSTS Preload List noch ein max-age unter einem Jahr. Inzwischen verlangt sie mindestens ein Jahr.
Für normalen Web-Traffic spielt das keine Rolle. Steht deine Domain aber auf der HSTS Preload List, fallen sechs Monate bei der Prüfung durch. Wir überschreiben deshalb den Default von haproxy-ingress und schicken max-age=31536000, also ein Jahr wie bisher bei ingress-nginx.
Brauchst du eine andere Dauer, setzt du spec.forProvider.hsts.maxAge auf der Ressource IngressHAProxy, als Zeitdauer, zum Beispiel 8760h. Für einen einzelnen Ingress setzt du haproxy-ingress.github.io/hsts-max-age, in Sekunden.
Request Buffering
Unter ingress-nginx erzeugten Endpunkte mit vielen Schreibzugriffen solche Warnungen in den Logs des Controllers:
[warn] a client request body is buffered to a temporary file /tmp/nginx/client-body/0000000123
  request: "POST /loki/api/v1/push HTTP/1.1"
Vor einiger Zeit lief ein Node in unserem Service-Cluster auf 98 % CPU, und der nginx-Pod darauf brauchte 1,4 Kerne vor allem dafür, temporäre Puffer auf die Disk zu schreiben und wieder aufzuräumen. Bei nginx half nur, nginx.ingress.kubernetes.io/proxy-request-buffering: "off" auf Ingresses mit vielen Schreibzugriffen zu setzen, etwa bei Loki, Promscale und Container Registries.
HAProxy streamt Request Bodies standardmässig direkt ans Backend. Eine entsprechende Annotation zum Puffern gibt es nicht, weil HAProxy eingehende Daten nicht auf die Disk schreibt.
Was das für dich heisst
Nutzt du auf NKE noch unser Managed ingress-nginx: Wie angekündigt endete der Support am 1. Oktober 2026. HAProxy steht auf jedem NKE-Cluster zur Verfügung, und unsere Dokumentation zur Migration ist der richtige Einstieg.
Bist du unsicher, wie sich einer dieser Unterschiede auf deine Workloads auswirkt, schreib uns an support@nine.ch. Wir schauen es gerne gemeinsam mit dir an.
