 Status










Am Abend des 11. August 2026 wurde einer unserer Kunden zum Ziel eines der grössten Angriffe, die wir je gegen unsere Infrastruktur gesehen haben. Weil wir für diesen Kunden die Anbindung ans Internet betreiben, traf die Wucht des Angriffs auch uns direkt, und wenige Stunden später richtete sich der Angreifer zusätzlich gegen unsere eigenen Dienste. Wir haben dazu bereits ein technisches Postmortem als PDF veröffentlicht. In diesem Beitrag wollen wir etwas ausführlicher erzählen, was in diesen drei Tagen passiert ist, warum die Bewältigung eines Angriffs dieser Grösse so lange gedauert hat, und was wir seither an unserer Infrastruktur verändert haben.
Ein Angriff, der unsere eigene Kapazität überstieg
Zur Einordnung der Grössenordnung: Wir gehen von einem Spitzenvolumen von geschätzt 500 bis 600 Gbit/s aus, das über all unsere Verbindungen zusammen auf unser Netzwerk und den betroffenen Kunden einprasselte. Zwei unserer Upstream-Provider haben uns davon 260 Gbit/s direkt bestätigt. Das ist ein Mehrfaches dessen, was unsere eigene Anbindung überhaupt transportieren kann, unabhängig davon, wie gut die Verteidigung im eigenen Netzwerk aufgestellt ist.
Betroffen waren über die gesamte Dauer immer wieder unterschiedliche Dienste: sämtliche Applikationen auf Deploio, unsere eigene Website, das Cockpit und unser Ticketsystem. Wichtig ist dabei die Betonung auf «immer wieder»: Es handelte sich nicht um einen einzigen, durchgehenden Ausfall von rund 42 Stunden, sondern um eine Serie von Wellen, zwischen denen der Betrieb jeweils wieder normal lief. Von Dienstagabend, ca. 19:15 Uhr, bis Donnerstagmittag, ca. 12:51 Uhr, kehrten diese Wellen immer wieder, jedes Mal mit wechselnden Zielen und wechselnder Intensität.
Was während der ganzen Zeit nie zur Debatte stand: der Schutz deiner Daten. Es gab keinen unbefugten Zugriff und keine kompromittierten Systeme. Der Angriff war Überlastung, kein Einbruch.
Von aussen bestätigt
Unabhängige Telemetriedaten des Threat-Research-Teams Deepfield von Nokia stützen unsere eigene Einschätzung des Ablaufs. Ihre Sensoren sind selbst als Bots bei genau den Command-and-Control-Servern (C2) der Angreifer registriert und protokollieren so die tatsächlich verschickten Angriffsbefehle, nicht nur den Traffic, der später beim Ziel ankommt. Diese Daten zeigen zwei beteiligte Botnetz-Familien, CECbot und Katana, und bestätigen die Reihenfolge, die wir selbst beobachtet haben: Der Angriff traf zunächst gezielt unseren Kunden, unsere eigene Infrastruktur kam erst rund drei Stunden später dazu, genau das Muster, das zu erwarten wäre, wenn wir getroffen wurden, weil wir dessen Internetanbindung betreiben, und nicht, weil wir selbst das eigentliche Ziel waren.
Ein Detail kam dabei zusätzlich zum Vorschein: Unser Kunde announciert seinen Adressblock über zwei unterschiedliche Provider, uns und einen weiteren, wer diesen Angriff also nur anhand unseres eigenen Netzwerks filtern oder zuordnen wollte, hätte immer nur die halbe Wahrheit gesehen. Nokias Daten treffen keine Aussage zur Täterschaft, das tun wir ebenfalls nicht.
Wie so ein Angriff überhaupt funktioniert
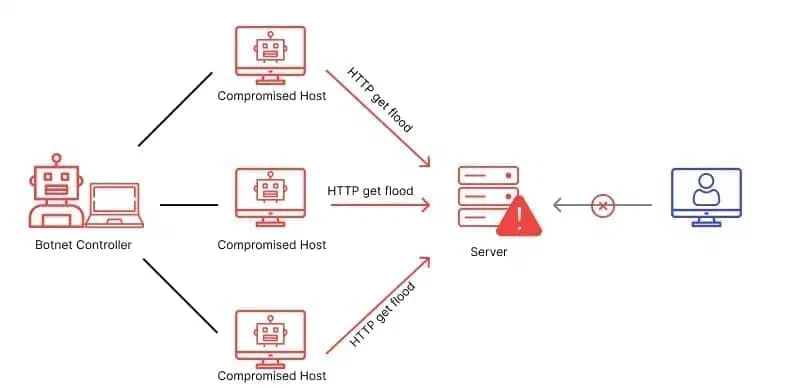
Die Angreifer nutzten eine Technik namens UDP-Amplification. Vereinfacht gesagt: Man schickt kleine Anfragen an offene Dienste im Internet, gibt dabei aber nicht die eigene Adresse als Absender an, sondern die des Opfers. Weil die Antwort um ein Vielfaches grösser ausfällt als die ursprüngliche Anfrage, trifft sie nicht den Angreifer, sondern direkt das Ziel. Aus vergleichsweise wenig eigener Bandbreite lässt sich so ein gewaltiges Angriffsvolumen erzeugen, verteilt über zehntausende Absender weltweit. Wer die Mechanik im Detail nachlesen will: Die CISA beschreibt das Verfahren ausführlich unter dem Stichwort «UDP-Based Amplification Attacks».
Der entscheidende Punkt für alles, was danach passiert: Sobald die eigene Internetanbindung voll ist, bringt Filtern im eigenen Netzwerk nichts mehr. Die Pakete, die man aussortieren möchte, haben die Leitung dann schon verstopft, zusammen mit allem legitimen Traffic, der auch noch durch dieselbe Leitung wollte. Ab diesem Punkt kann eine Abwehr nur noch weiter draussen ansetzen, bei den Providern, über die der Traffic überhaupt erst zu uns kommt.
Das Mittel dafür heisst Blackholing. Wir bitten unsere Upstream-Provider, den gesamten Traffic zu einer bestimmten Adresse gar nicht erst zu uns zu schicken, sondern zu verwerfen. Das schützt zuverlässig das gesamte Netzwerk und alle anderen Kundinnen und Kunden, die nichts mit dem Angriff zu tun haben. Der Preis dafür: Die betroffene Adresse ist während dieser Zeit bewusst nicht erreichbar, für niemanden, auch nicht für echte Besucherinnen und Besucher. Genau das war während dieses Vorfalls oft der Grund, warum eine Applikation nicht lief. Nicht, weil etwas kaputt war, sondern weil wir diese eine Adresse geopfert haben, um den Rest stabil zu halten.
Erschwerend kam hinzu, dass der Angreifer sich nicht abschrecken liess: Als wir unsere eigene Website auf eine neue IP-Adresse umzogen, war diese neue Adresse innerhalb weniger Minuten ebenfalls im Visier. Und es ging nicht nur um reine Datenmenge: Die schiere Anzahl an Anfragen reichte bei einzelnen Diensten aus, um sie zu überlasten, unabhängig vom Bandbreitenvolumen. Das verlangte nach einem anderen Werkzeug als Blackholing, eines, das legitimen von bösartigem Traffic unterscheiden kann, statt beides pauschal zu blockieren.
Der Weg zurück zur Verfügbarkeit
Genau hier kam die Massnahme ins Spiel, die den Vorfall letztlich beendet hat: Als klar wurde, dass Blackholing allein nicht ausreicht gegen einen Angreifer, der uns auch über die schiere Anzahl an Anfragen zusetzte, begannen wir, einen Tag nach Beginn des Vorfalls, unsere exponierten Applikationen hinter bunny.net zu stellen, ein europäisches CDN mit eingebautem DDoS-Schutz, die Migration war am Folgetag abgeschlossen. Auch unser Kunde hat auf seiner Seite parallel zusätzliche Schutzmassnahmen umgesetzt. Der Angriffs-Traffic bleibt seither beim Schutzanbieter hängen, legitime Anfragen kommen weiterhin zu uns durch.
Ein Punkt, der uns in diesen drei Tagen konkret geholfen hat: Weil wir unser Netzwerk selbst betreiben, konnten wir Routing-Anpassungen direkt während des laufenden Angriffs vornehmen und die zusätzlichen Schutzmassnahmen koordinieren, ohne auf Änderungen bei einer darunterliegenden, fremden Netzwerkinfrastruktur warten zu müssen. Das ist mit ein Grund, warum aus einem Angriff dieser Grössenordnung kein tagelanger Totalausfall wurde.
Drei Lücken, die wir gefunden haben
Wir haben in diesem Vorfall drei konkrete Lücken gefunden, und wir sagen das lieber offen, als sie zu verschweigen.
Erstens: Unsere automatische Angriffserkennung war ausschliesslich auf unsere eigenen Adressen ausgelegt. Netze, die zwar über uns ins Internet announciert werden, aber einem Kunden gehören, waren nicht Teil dieser Automatik. Genau ein solches Netz war das erste Ziel des Angriffs, weshalb die erste Welle rund 90 Minuten lang nur manuell eingedämmt werden konnte. Diese Lücke haben wir noch in derselben Nacht geschlossen.
Zweitens: Wir hatten nie systematisch überprüft, ob unser Blackhole-Signal auf jedem einzelnen Übertragungsweg tatsächlich wirkt. Das Signal gilt nämlich nur für Peers, mit denen Blackholing vorher explizit vereinbart wurde, oder für Traffic, der über die Routeserver eines Internet Exchange zu uns kommt. An den Internet Exchanges, an denen wir angeschlossen sind, haben wir mit keinem unserer direkten Peers eine solche Vereinbarung, Blackholing deckt dort also nur Traffic ab, der über die Routeserver läuft, nicht direkt ausgetauschten Traffic. Weil wir zudem noch keine Möglichkeit hatten, ein einzelnes Netz gezielt gegenüber nur einem bestimmten Provider zurückzuhalten, mussten wir dieses Werkzeug erst während des laufenden Angriffs entwickeln, unter Volllast. Es hat funktioniert, aber ein Werkzeug im Ernstfall zu bauen statt es bereits einsatzbereit zu haben, ist immer die langsamere und riskantere Variante.
Drittens, und das war für viele Kundinnen und Kunden die unangenehmste Auswirkung: Unsere eigene Website läuft auf derselben Deploio-Plattform wie deine Applikationen. Als der Angriff auf unsere Website zielte, waren automatisch auch fremde Applikationen auf derselben Plattform betroffen. Und weil zu einem späteren Zeitpunkt auch das Cockpit und das Ticketsystem direkt angegriffen wurden, verloren manche Kundinnen und Kunden gleichzeitig ihre Applikation, den Zugriff auf deren Verwaltung und einen Teil ihrer Möglichkeiten, uns überhaupt zu erreichen. Genau in dem Moment, in dem sie uns am dringendsten gebraucht hätten.
Was seither anders ist
Alle drei Lücken sind mittlerweile geschlossen oder aktiv in Arbeit. Jedes Kundennetz, das wir announcen, ist automatisch Teil unserer Angriffserkennung, das ist inzwischen fest im Standardprozess verankert. Unsere exponierten Applikationen bleiben dauerhaft hinter bunny.nets CDN mit DDoS-Schutz, die Migration weiterer Dienste ist als fertiges Verfahren vorbereitet, nicht mehr etwas, das wir im Ernstfall improvisieren müssten. Wir überwachen die Wirksamkeit unserer Abwehr inzwischen über alle Verbindungswege hinweg und arbeiten dafür enger mit unseren Upstream-Providern zusammen.
Und weil wir unsere eigenen Dienste bewusst nicht von der Deploio-Plattform abziehen wollen, sondern weiterhin dieselbe Plattform nutzen wie unsere Kundinnen und Kunden, arbeiten wir stattdessen daran, sie robuster zu machen: Wir entwickeln die Architektur so weiter, dass einzelne Applikationen künftig weniger von gemeinsam genutzten Adressen abhängen. Das Cockpit und das Ticketsystem sind zusätzlich besser abgesichert, damit du uns auch während eines Angriffs erreichen kannst. Und das Szenario dieses Vorfalls ist jetzt fester Bestandteil unserer regelmässigen Übungen, nicht mehr nur graue Theorie.
Was du selbst tun kannst
Aus diesem Vorfall ergibt sich eine ganz konkrete Empfehlung für alle, die eigene Domains auf Deploio betreiben.
Verwende einen CNAME- oder ALIAS-Record statt eines A-Records. Ein A-Record bindet deine Domain fest an eine bestimmte IP-Adresse auf unserer Plattform. Genau diese feste Bindung war während des Angriffs ein Problem: Wo wir die Adresse kurzfristig wechseln konnten, liess sich die Verfügbarkeit wiederherstellen, wo nicht, blieb uns nur die grobe Massnahme. Dazu kommt: Über eine gemeinsame Adresse sind oft auch andere Applikationen erreichbar, was genau das Risiko erzeugt, das wir oben beschrieben haben. Das ist in erster Linie ein architektonisches Problem auf unserer Seite, an dem wir arbeiten. Bis dahin ist ein CNAME oder ALIAS die wirksamste Einzelmassnahme, die du selbst umsetzen kannst.
Und stelle, wo immer möglich, ein CDN mit eigenem DDoS-Schutz vor deine Applikation. Genau das war die Massnahme, die bei uns die Verfügbarkeit wiederhergestellt hat. Für die meisten Setups ist der Aufwand überschaubar und die laufenden Kosten sind gering.
Wenn du unsicher bist, welche Variante zu deiner Applikation passt, melde dich bei support@nine.ch. Wir gehen das gerne gemeinsam mit dir durch.
Den vollständigen technischen Ablauf, inklusive Chronologie und Zeitangaben, findest du im offiziellen Postmortem als PDF.
Zum Schluss
Einen Angriff dieser Grössenordnung können wir nicht vollständig verhindern, das liegt schlicht ausserhalb unserer Kontrolle. Was wir beeinflussen können, ist wie schnell wir reagieren und wie wenige unbeteiligte Kundinnen und Kunden davon mitgetroffen werden, und genau daran arbeiten wir seit diesem Vorfall weiter. Wir entschuldigen uns für die Unannehmlichkeiten während dieser drei Tage und danken dir für deine Geduld.
